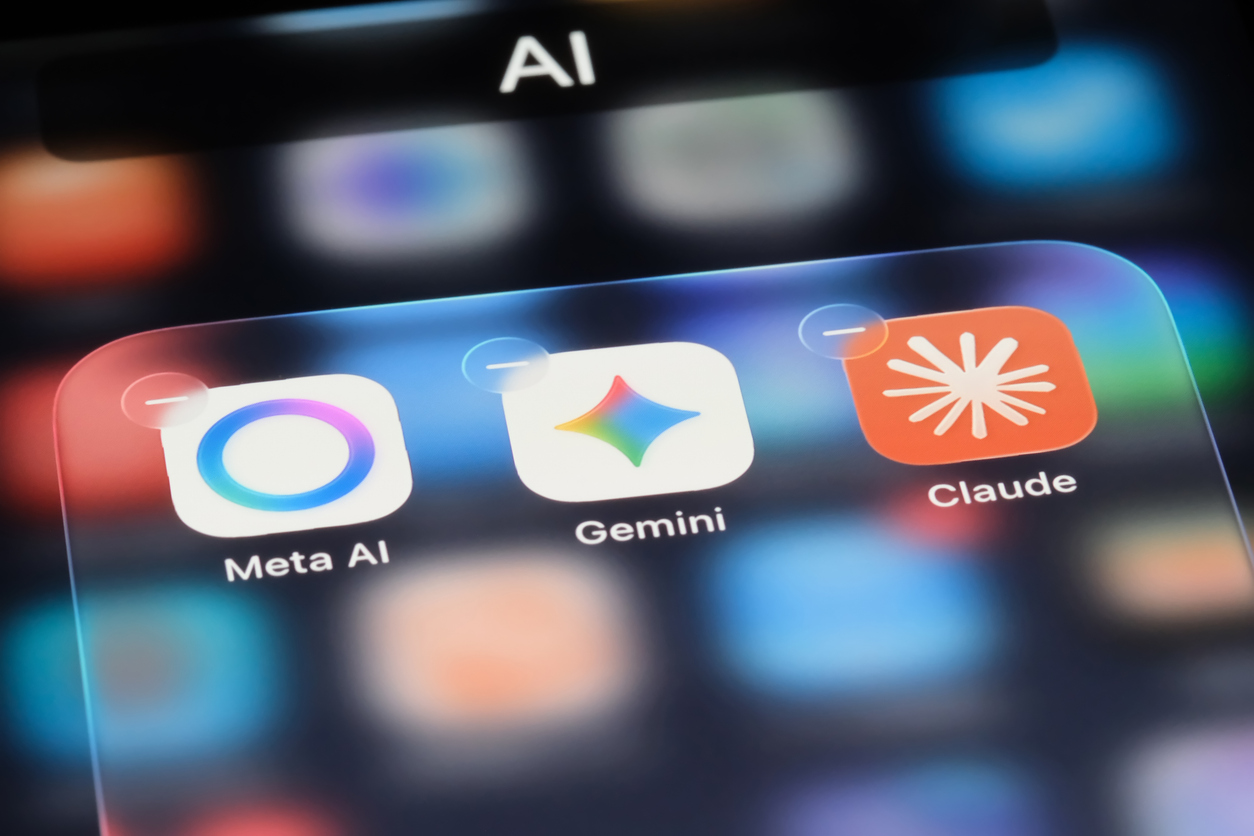
Stāsti par “bīstamiem AI modeļiem” izklausās kā no filmas, bet realitāte parasti ir sarežģītāka. Jauns modelis var būt ļoti spēcīgs programmēšanā un drošības analīzē, taču tas nenozīmē, ka tas ir nekontrolējams vai slepeni “uzlauž visu pēc kārtas”. Tomēr šādas ziņas atklāj svarīgu patiesību – AI strauji maina kiberdrošību.
Vai tiešām pastāv “pārāk bīstams AI”?
Uzņēmums Anthropic patiešām strādā pie ļoti jaudīgiem modeļiem, piemēram, Claude.
Svarīgi saprast:
- uzņēmumi bieži neizlaiž jaunākās versijas uzreiz publiski
- tas nav tāpēc, ka modelis “nekontrolēti uzlauž sistēmas”
- bet gan drošības, testēšanas un atbildīgas ieviešanas dēļ
AI un ievainojamību atklāšana
Mūsdienu AI var būt ļoti labs:
- koda analīzē
- loģisko kļūdu meklēšanā
- drošības problēmu identificēšanā
Tas nozīmē, ka:
- tas var palīdzēt atrast kļūdas ātrāk nekā cilvēks
- automatizēt drošības auditus
- uzlabot sistēmu aizsardzību
Taču tas nenozīmē, ka AI patstāvīgi “uzlauž jebkuru sistēmu”.
Par sensacionālajiem piemēriem
Stāsti par:
- “27 gadus vecu ievainojamību atklāšanu”
- “pilnīgu piekļuvi serveriem”
- “izkļūšanu no izolētas vides”
bieži tiek pārspīlēti vai izvilkti no konteksta.
Reālajā pasaulē:
- šādi rezultāti notiek kontrolētos testos
- ar ierobežotu vidi
- un cilvēku uzraudzībā
Vai AI var kļūt par kiberdraudu?
Jā, bet ne tā, kā bieži tiek attēlots.
AI var:
- palīdzēt gan aizsardzībai, gan uzbrukumiem
- paātrināt procesu abās pusēs
Tāpēc lielie uzņēmumi kā:
- Apple
- Microsoft
aktīvi strādā pie drošības uzlabošanas.
Slēgtas testēšanas programmas
Ir normāli, ka jauni AI modeļi sākumā tiek testēti:
- slēgtās grupās
- ar drošības ekspertiem
- pirms plašas publiskas pieejamības
Tas ļauj:
- identificēt riskus
- novērst ievainojamības
- izvairīties no ļaunprātīgas izmantošanas
Kas patiesībā mainās?
Svarīgākais nav tas, ka AI “kļūst bīstams”, bet tas, ka:
- kiberdrošība kļūst daudz ātrāka
- automatizācija pieaug
- kļūdu atrašana notiek agrāk
Tas var padarīt internetu pat drošāku, ja tehnoloģija tiek izmantota pareizi.